1절 — 10주 전의 나
신청하기까지 오래 고민했습니다.
10주는 길게 느껴졌고, 가격도 부담이 없진 않았습니다. 이 글을 읽고 계신 분도 아마 비슷한 지점에서 멈춰 계실 겁니다.
결정은 결국 단순한 데서 났습니다. 우물 안 개구리에서 벗어나고 싶었고, 개발자로서 더 성장하고 싶었습니다. 그 목적에 비하면 돈이 아깝지 않다는 생각이 들었고, 그러고 나니 손이 움직였습니다.
그때 제 상태가 어땠는지도 적어두는 게 좋겠습니다.
10주 전에도 AI는 쓰고 있었습니다. 다만 쓰는 범위가 정해져 있었습니다. 구현은 통째로 맡기고, 저는 동작하는 기능을 설계하는 데 초점을 뒀습니다.
나쁜 방식이라고 생각하지 않았습니다. 설계는 내가 하고 타이핑은 AI가 한다, 역할이 깔끔하게 나뉜 것처럼 보였으니까요.
그런데 그 구도에는 빈자리가 하나 있었습니다. AI가 돌려준 구현을 무엇을 보고 받아들일지가 정해져 있지 않았습니다. 동작하면 통과였습니다.
1주차 과제 문서의 첫 줄이 정확히 그 자리를 겨냥하고 있었습니다.
"잘 돌아가는 코드"와 "좋은 코드"는 다르다.
2절 — 매일매일을 그냥 보내지 않는 곳
이 프로그램은 React를 가르치는 과정이 아닙니다. 1주차 과제 문서의 첫 줄이 이렇게 시작합니다.
"잘 돌아가는 코드"와 "좋은 코드"는 다르다. 이번 주는 기능 구현이 아니라, 그 차이를 구분하는 눈과 그걸 강제하는 환경을 만든다.
그래서 1주차에 만든 건 기능이 아니라 ESLint 설정과 git hook이었습니다. 그리고 10주 내내 적용되는 규칙이 하나 있습니다.
본인이 설명할 수 없는 코드는 커밋하지 않는다.
AI가 쓴 코드도 머지하는 순간 내 코드다, 라는 뜻입니다. 나머지 아홉 주는 전부 이 하나를 지키기 위한 기술이었습니다.
과제도 "만들어 오세요"가 아니었습니다. 7주차는 "빠른 숫자를 만들려고 느린 API를 없애지 않는다"로 시작하고, 8주차는 "커버리지 숫자를 올리지 않는다"로 시작합니다. 무엇을 하지 말아야 하는지가 먼저 적혀 있습니다.
라운드마다 열린 라이브 세션도 같은 이야기를 했습니다.
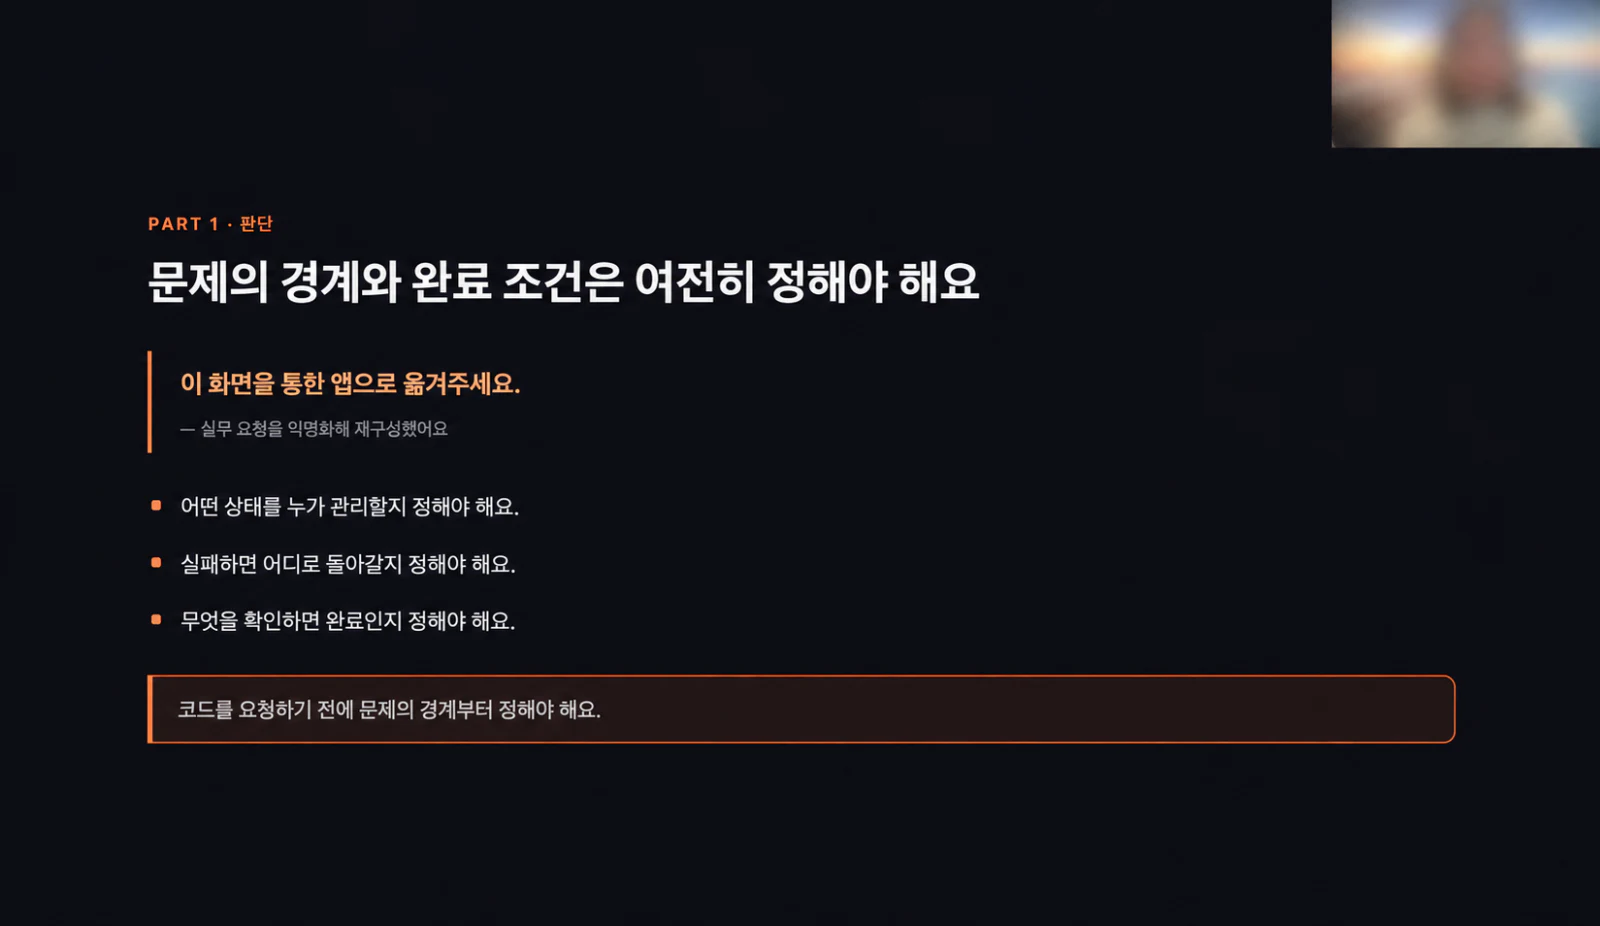
코드를 요청하기 전에 문제의 경계부터 정한다
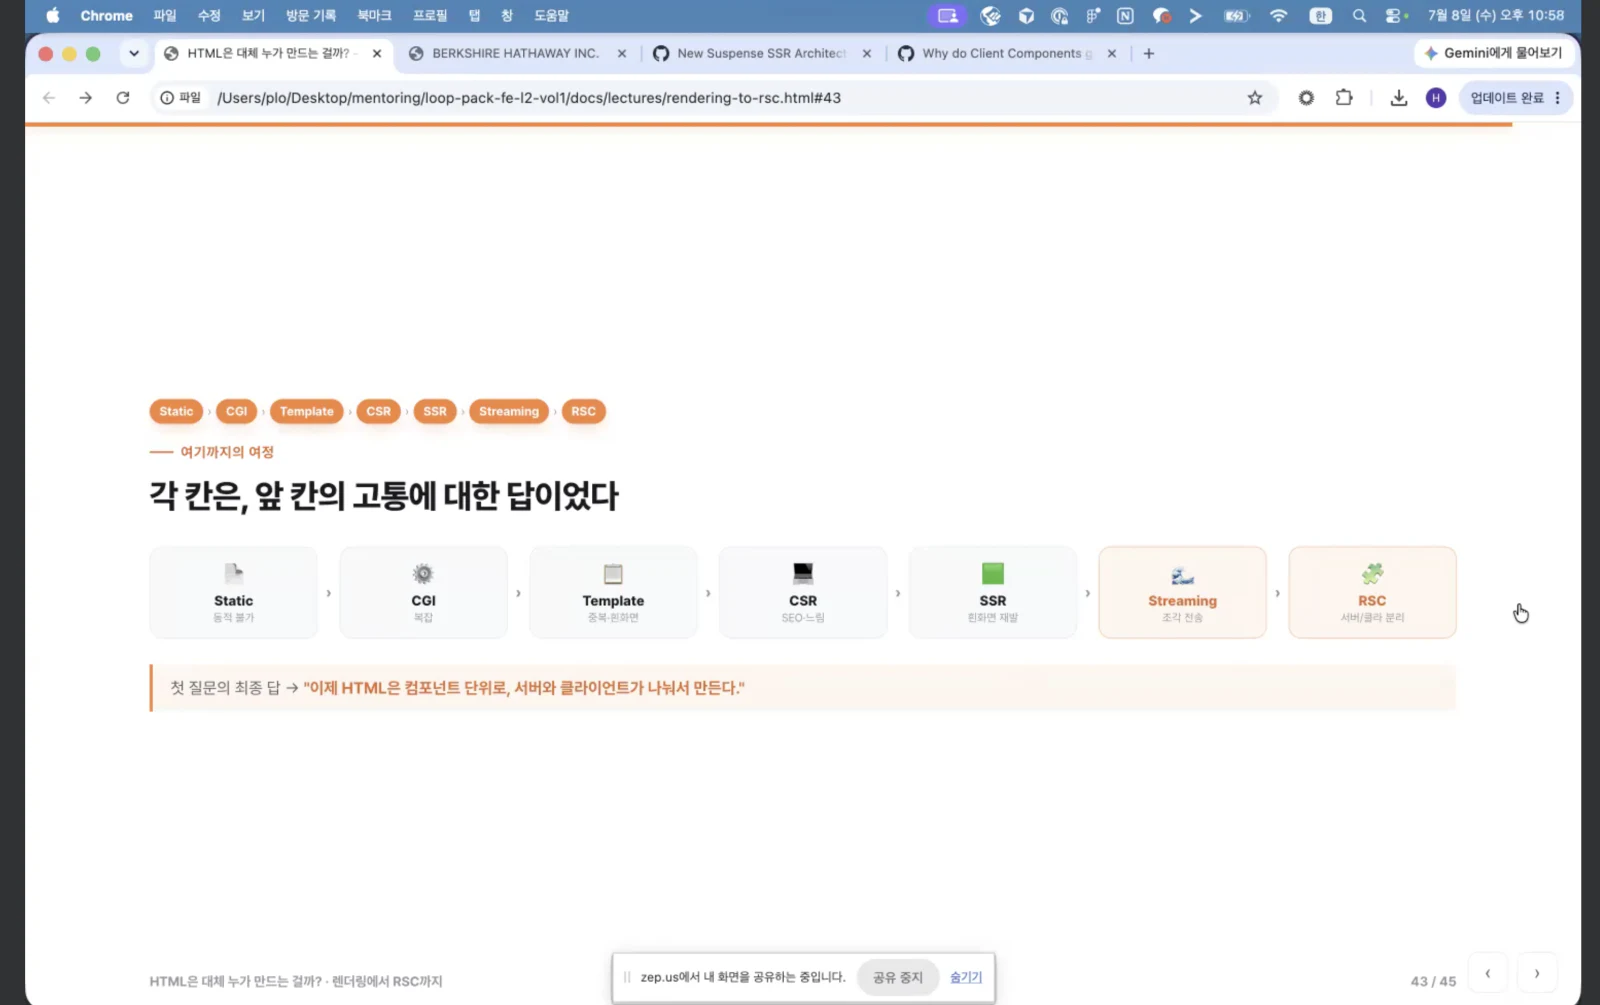
렌더링 방식의 변천사 — 각 칸은 앞 칸의 고통에 대한 답이었다
혼자 하는 과정은 아니었습니다
평일에는 zep에 코어타임이 있었습니다. 가상 오피스에 팀별로 자리가 있고, 아바타 머리 위에 "학습중"이 떠 있습니다. 매니저 자리도 따로 있습니다.
하는 일은 단순합니다. 각자 자기 과제를 하면서 같은 공간에 앉아 있는 것. 그리고 막히면 서로 물어봅니다.
별것 아닌 것 같은데, 혼자 하면 막혔을 때 그냥 덮고 넘어가게 됩니다. 옆자리에 같은 과제를 하는 사람이 앉아 있으면 그게 잘 안 됩니다.
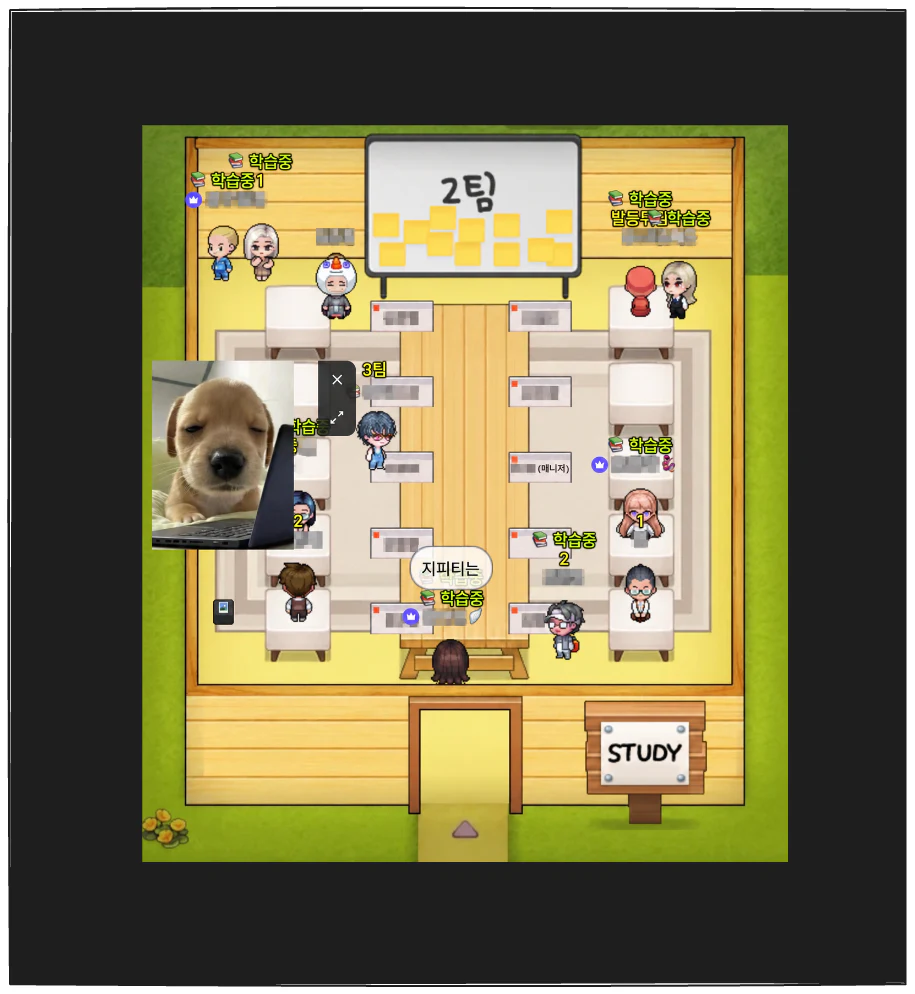
평일 코어타임 — 팀별 자리에 "학습중"을 달고 각자 과제를 한다
3절 — 변화 1: AI와 나의 경계선
1주차에 만든 건 기능이 아니라 게이트였습니다. ESLint flat config를 깔고, husky와 lint-staged로 커밋 훅을 걸었습니다. 그리고 설정이 끝난 뒤에 일부러 lint 오류가 있는 파일을 커밋해 봤습니다. 실제로 막히는지 확인하려고요. 그 검증 자체가 과제의 완료 기준이었습니다.
git hook은 제가 만든 커밋에도, AI가 만든 커밋에도 똑같이 걸립니다. "AI를 통제한다"는 말의 가장 구체적인 형태가 이거였습니다.
그런데 그 게이트를 세워놓고도 3주차에 이런 피드백을 받았습니다.
PR 표엔 "useDebouncedValue로 검색어 300ms 지연"이라 적혀있는데, 실제 저장소엔 useDebouncedValue 파일 자체가 없어요. 검색어가 키 입력마다 바로 URL·fetch에 반영돼서 이 항목은 표기와 다르게 아직 미해결이에요.
제가 PR 체크리스트에 체크해서 올린 항목이었습니다. 파일이 없는데 체크가 되어 있었습니다.
이어진 지적이 더 뼈아팠습니다.
AI로 초안 작성 후 검토하셨다고 했는데, 검토 단계에서 실제로 눌러보고 확인하는 과정이 빠졌던 것 같아요. 체크리스트에 체크하기 전에 그 기능을 직접 화면에서 확인하는 습관을 들이면 이런 간극을 미리 잡을 수 있을 거예요.
lint와 타입은 기계가 잡습니다. 그런데 "체크리스트에 적은 것이 실제로 저장소에 있는가"는 기계가 안 잡습니다. 제가 검토했다고 생각한 것과 실제로 검토한 것 사이의 간격이 거기 있었습니다.
10주 뒤에는 그 경계가 좀 더 분명해졌습니다. 지금 이 저장소에는 게이트가 두 겹으로 걸려 있습니다.
.husky/pre-commit   pnpm lint-staged
.husky/pre-push     pnpm tsc --noEmit
여기에 10주차에 CI를 얹었습니다. 환경 변수 검증 → Lint → Typecheck → Test → Build 순서로 도는 job과, 그와 독립적으로 도는 E2E job. 둘 다 머지 필수 조건으로 걸었습니다.
그리고 이번에도 일부러 깨뜨려서 확인했습니다. 타입 오류를 한 줄 넣은 PR을 올렸더니 Typecheck와 Build가 실패하고, 머지 버튼이 비활성화되고, PR 상태가 BLOCKED으로 바뀌었습니다. 확인한 뒤 그 줄을 지우는 커밋을 따로 남겼습니다.
이게 제가 10주 동안 바꾼 첫 번째입니다. 기계가 결정적으로 잡을 수 있는 건 전부 기계에 넘기고, 남은 것만 내가 본다. 그리고 기계에 넘겼다고 믿는 대신, 일부러 깨뜨려서 정말 막히는지 확인한다.
4절 — 변화 2: 근거로 설계하기
8주차 과제 문서는 이렇게 시작합니다.
이번 주에는 커버리지 숫자를 올리지 않아요. 프론트엔드는 지켜야 할 스펙이 어디에도 적혀 있지 않으니, 무엇을 어떻게 검증할지 먼저 정하고 그것만 테스트로 고정해요. 그리고 내가 쓴 테스트가 진짜로 무언가를 잡는지 직접 확인해요.
마지막 문장이 과제의 핵심이었습니다. 테스트를 쓰는 게 아니라, 쓴 테스트를 의심하는 것.
방법은 코드를 일부러 망가뜨려 보는 것이었습니다. 페이지 수를 계산하는 자리에서 Math.ceil을 Math.round로 바꿨습니다. 올림을 반올림으로 바꿨으니 페이지 수가 틀어져야 하고, 테스트 중 하나는 실패해야 정상입니다.
하나도 실패하지 않았습니다.
원인을 찾아보니 이랬습니다. 그 함수를 검증하는 단위 테스트 여섯 개가 전부 totalCount=30, pageSize=12를 쓰고 있었습니다. 30 ÷ 12 = 2.5인데, 0.5는 올림과 반올림의 결과가 같아지는 유일한 소수부입니다. 테스트가 여섯 개였지만 픽스처는 하나였고, 그 하나가 하필 구분이 안 되는 값이었습니다.
더 볼 만한 건 그다음이었습니다. 단위 테스트가 놓친 이 변형을 통합 테스트 세 개가 대신 잡았습니다. 그런데 그것도 설계가 아니었습니다. 통합 테스트의 스텁이 우연히 14 ÷ 12 = 1.17을 쓰고 있어서였습니다. 스텁의 총 개수를 12개나 24개로 바꾸는 순간 그 방어도 사라집니다.
즉 비싼 계층이 싼 계층의 일을 우연히 대신하고 있는 배치였습니다. 테스트는 전부 초록불이었고, 커버리지로는 이 상태가 전혀 보이지 않습니다.
"테스트가 통과한다"와 "테스트가 무언가를 지킨다"는 다른 말이라는 걸, 숫자로 확인한 게 이 주차였습니다.
관련 글: 8주차
5절 — 변화 3: 안 보이던 게 보인다
가장 기억에 남는 주차를 하나 고르라면 7주차입니다.
재기 전에 조건부터 고정했다
과제가 요구한 건 개선이 아니라 순서였습니다. 같은 URL과 같은 행동을, production build 위에서, 같은 쓰로틀링 조건으로 5회 반복 측정하고 중앙값을 쓸 것.
처음엔 이게 번거로운 절차라고 생각했습니다. 실제로 재보니 이 절차 자체가 판단의 근거였습니다. Before 측정에서 LCP 5회의 범위가 39.8ms였습니다. 중앙값의 0.48%. 이 숫자가 나온 뒤에야 "39.8ms보다 큰 변화만 개선이라고 말할 수 있다" 는 기준이 생겼습니다. 이걸 안 재고 시작했으면 측정 노이즈를 개선이라고 우겼을 겁니다.
첫 번째 가설은 틀렸다
들어가기 전 제 짐작은 "홈 페이지 전체가 데이터를 기다려서 느리다"였습니다. 렌더링 경계를 나누면 되겠다고 생각했습니다.
실측은 그걸 지지하지 않았습니다. LCP 8,225.4ms 중에서 서버 응답을 기다린 시간은 13.9ms, 전체의 0.17% 였습니다. 필름스트립을 봐도 첫 프레임(1,025ms)에서 헤더·제목·설명·카테고리가 이미 다 그려져 있었습니다. 아무도 데이터를 기다리고 있지 않았습니다.
가설을 기각하고, 이 부분은 아무것도 건드리지 않았습니다.
진짜 원인
같은 LCP 8,225.4ms 안에서 이미지 전송이 8,000.8ms였습니다. 97.3%.
이유는 단순했습니다. 화면에 1200×675로 표시되는 이미지의 원본이 3840×2160이었고, 리사이즈도 재압축도 없이 그대로 내려가고 있었습니다. 7.20MB였습니다.
next/image로 표시 크기에 맞춰 WebP로 재인코딩한 뒤:
| Before | After | |
|---|---|---|
| 전송량 | 7,545,525 B (7.20 MB) | 80,965 B (79.1 KB) |
| 이미지 전송 구간 | 8,000.8 ms | 294.8 ms |
전송 바이트가 줄어든 만큼 전송 시간도 줄었으니 가설이 확인된 셈입니다.
홈 LCP 중앙값은 8,225.4ms에서 1,876.7ms가 됐습니다. 다만 이 두 값을 나란히 놓을 때 밝혀야 할 게 있습니다. Before 측정 이후에 홈 API에도 목록과 같은 지연 옵션이 적용돼서, After 쪽 조건이 Before보다 불리해졌습니다. 그래서 이 글에서 제가 가장 자신 있게 말할 수 있는 수치는 전체 LCP가 아니라 위 표의 이미지 전송 구간과 전송량입니다.
두 번째 가설도 틀렸다
정렬만 바꾸면 상품 개수는 그대로인데 CLS가 발생했습니다. 그때 카드 제목 높이가 69~140px로 들쭉날쭉한 걸 보고 원인을 짐작했습니다. 상품명이 2줄을 넘어 3줄이 되는 카드가 있어서 카드 높이가 제각각이고, 그게 레이아웃을 민다.
제목을 2줄로 클램프해서 높이를 고정했습니다. 제목 높이는 6장 전부 56px로 완전히 균일해졌고, 정렬 전후로 본문 높이가 1,703→1,760으로 변하던 것이 1,617→1,617로 아예 변하지 않게 됐습니다. 의도대로 된 겁니다.
그리고 CLS는 0.217439에서 0.217439가 됐습니다. 소수점 여섯 자리까지 똑같았습니다.
원인이 아예 다른 데 있었습니다. 브라우저가 알려주는 이동 요소를 열어보니, 움직인 건 카드 안의 제목이 아니라 카드 자체였습니다. 정렬이 바뀌면서 같은 DOM 노드가 그리드 안에서 자리를 옮긴 것이고(x=800에서 68로), 그 이동량은 제목을 아무리 균일하게 만들어도 줄어들지 않습니다.
클램프는 되돌렸습니다.
그래서 이 주차를 꼽는 이유
수치가 극적이어서가 아닙니다. 제 짐작이 두 번 틀렸고, 그걸 제가 직접 증명했기 때문입니다.
틀렸다는 걸 알려면 먼저 재야 하고, 재려면 조건을 고정해야 하고, 조건을 고정하려면 무엇을 비교할지 정해야 합니다. 이 순서를 한 번 제대로 밟아보고 나니, 회사 서비스를 볼 때도 보이는 게 달라졌습니다. 느리다는 인상 대신 "어디를 어떤 조건으로 재볼까"가 먼저 떠오릅니다.
누군가에게 이 프로그램을 권한다면 이 지점 때문입니다. 정답을 알려주는 과정이 아니라, 내 짐작이 틀렸다는 걸 스스로 증명하게 만드는 과정이라서.
관련 글: 7주차
6절 — 10주를 어떻게 굴렸나
여기는 솔직하게 적는 게 맞을 것 같습니다.
주당 20~30시간을 썼습니다. 회사 일과 병행했고, 다행히 업무 쪽에 여유가 있는 편이어서 가능했습니다.
이 숫자가 왜 이렇게 나오는지는 앞의 세 절을 보시면 짐작이 되실 겁니다. 7주차에는 LCP를 5회 측정하고, 변경한 뒤 또 5회를 측정하고, 그 뒤에 코드가 더 바뀌면서 같은 조건으로 한 번 더 측정했습니다. 8주차에는 테스트를 쓰는 것보다 쓴 테스트를 망가뜨려 보는 데 시간이 더 들었습니다.
구현만 하면 훨씬 적게 걸립니다. 근거를 남기는 데 시간이 듭니다.
과제 시간 외에도 슬랙에서 자료가 계속 오갔다
7절 — 멘토링: 감상이 아니라 코드 대조
피드백이 좋았다고 쓰는 후기는 많습니다. 그래서 어떤 종류였는지를 그대로 옮기는 게 나을 것 같습니다.
3절에 적은 그 지적 — PR 표에는 있는데 저장소에는 없던 파일 — 부터가 그렇습니다. 읽고 감상을 준 게 아니라 제 PR 본문과 실제 코드를 대조한 결과였습니다. 그리고 같은 피드백 안에 두 가지가 더 있었습니다.
흩어진 문제를 하나로 묶는 진단.
이 두 가지가 겹치면서 race condition 방지도 자연스럽게 안 된 상태예요 — 디바운스가 없으니 요청이 빨리 여러 번 나가는데, 그걸 무시하는 ignore/AbortController도 없거든요. 사실 이 세 가지는 한 원인(디바운스 미적용)에서 갈라진 문제라, useDebouncedValue 훅 하나만 실제로 만들어 넣으면 같이 해결될 가능성이 높아요.
저는 세 개의 문제로 보고 있었는데 하나였습니다.
내 짐작과 원인이 다를 때.
뒤로 가기가 동작하지 않는 문제가 있었습니다. 저는 replaceState를 써서 히스토리가 안 쌓이는 게 원인이라고 생각했습니다.
그런데 원인이 조금 특이해요 — useUrlSearchParams가 실제 브라우저 popstate가 아니라 직접 만드신 커스텀 이벤트만 구독하고 있어서, replaceState라 히스토리가 안 쌓이는 문제 이전에 진짜 뒤로가기를 눌러도 이 훅 자체가 반응을 안 해요.
제가 본 원인은 두 번째 원인이었고, 그 앞에 하나가 더 있었습니다. 이런 건 코드를 실제로 열어보지 않으면 나올 수 없는 지적입니다.
잘한 부분도 근거와 함께 왔습니다. 6주차에는 레이어 간 의존을 직접 검사한 결과를 붙여 줬습니다. grep -rn "features/\|widgets/\|_pages" src/entities src/shared 0건, features 간 교차 0건, widgets 간 교차 0건. "잘하셨어요"가 아니라 확인한 명령과 결과였습니다.
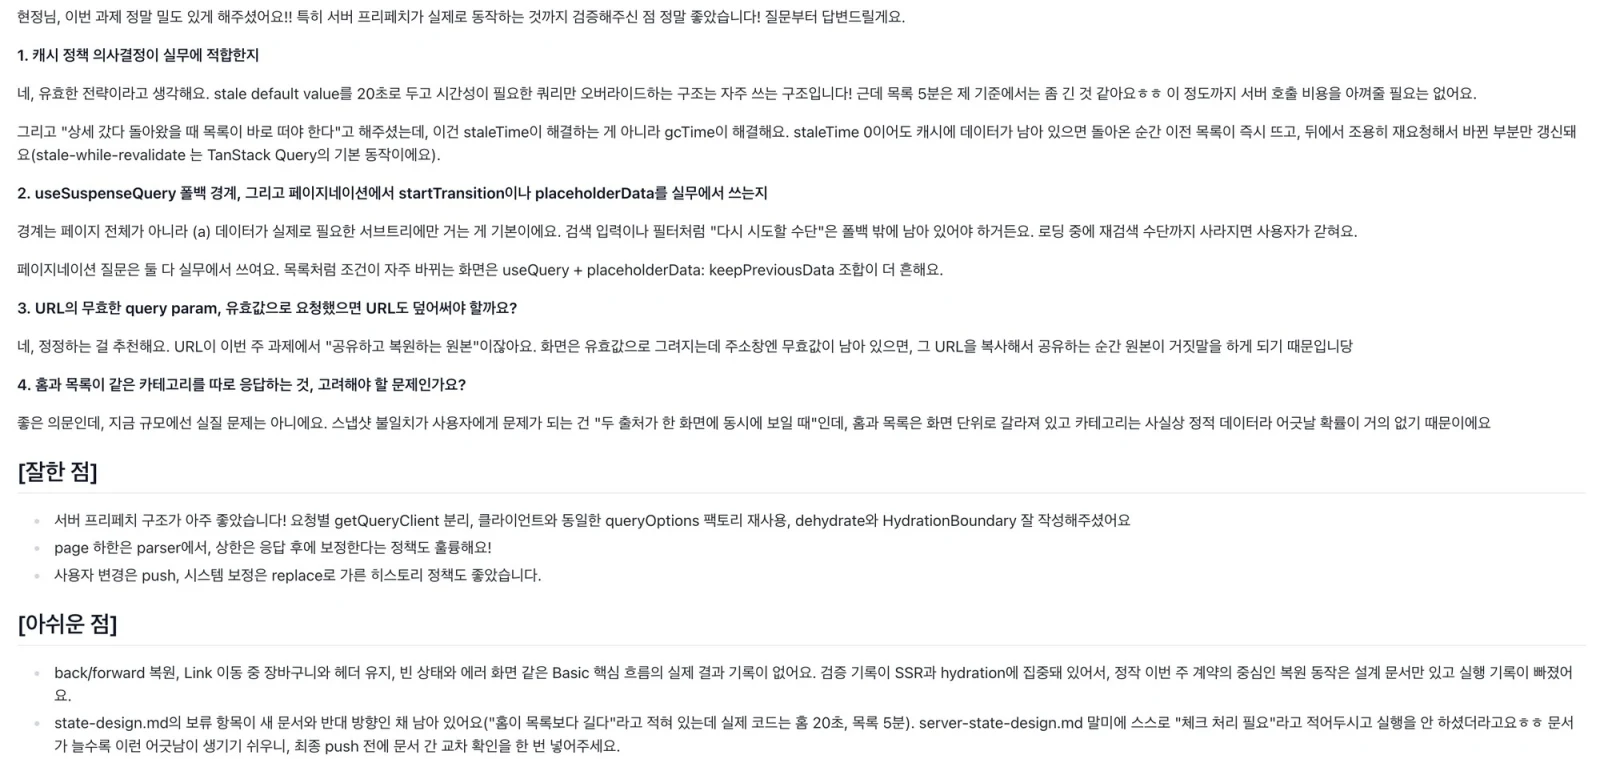
5주차 — 내가 물은 것보다 한 겹 아래를 짚어준 답변 (클릭하면 원본 크기)
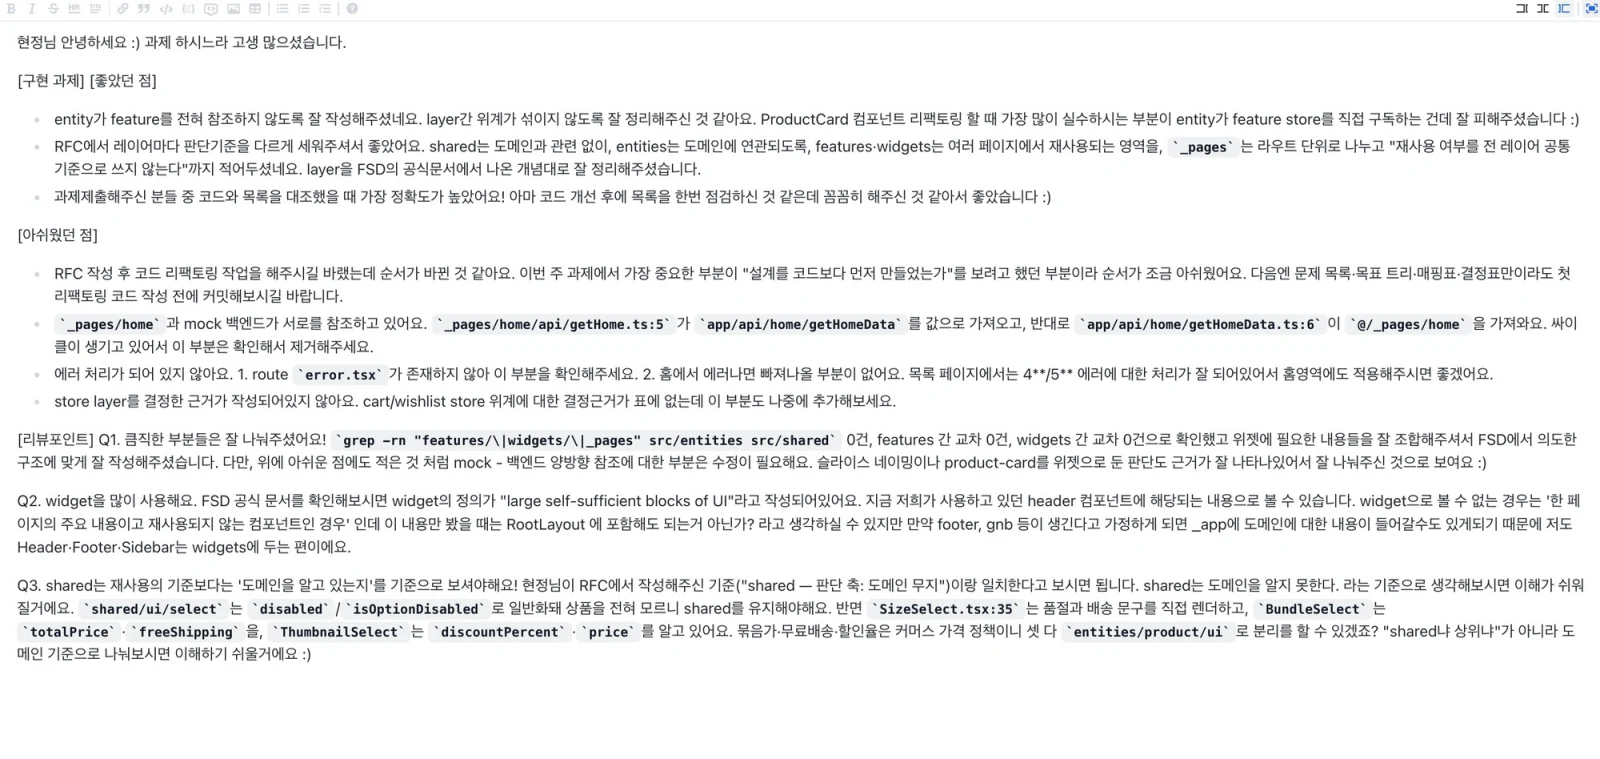
6주차 — 레이어 간 의존을 직접 검사해서 확인해 준 피드백 (클릭하면 원본 크기)
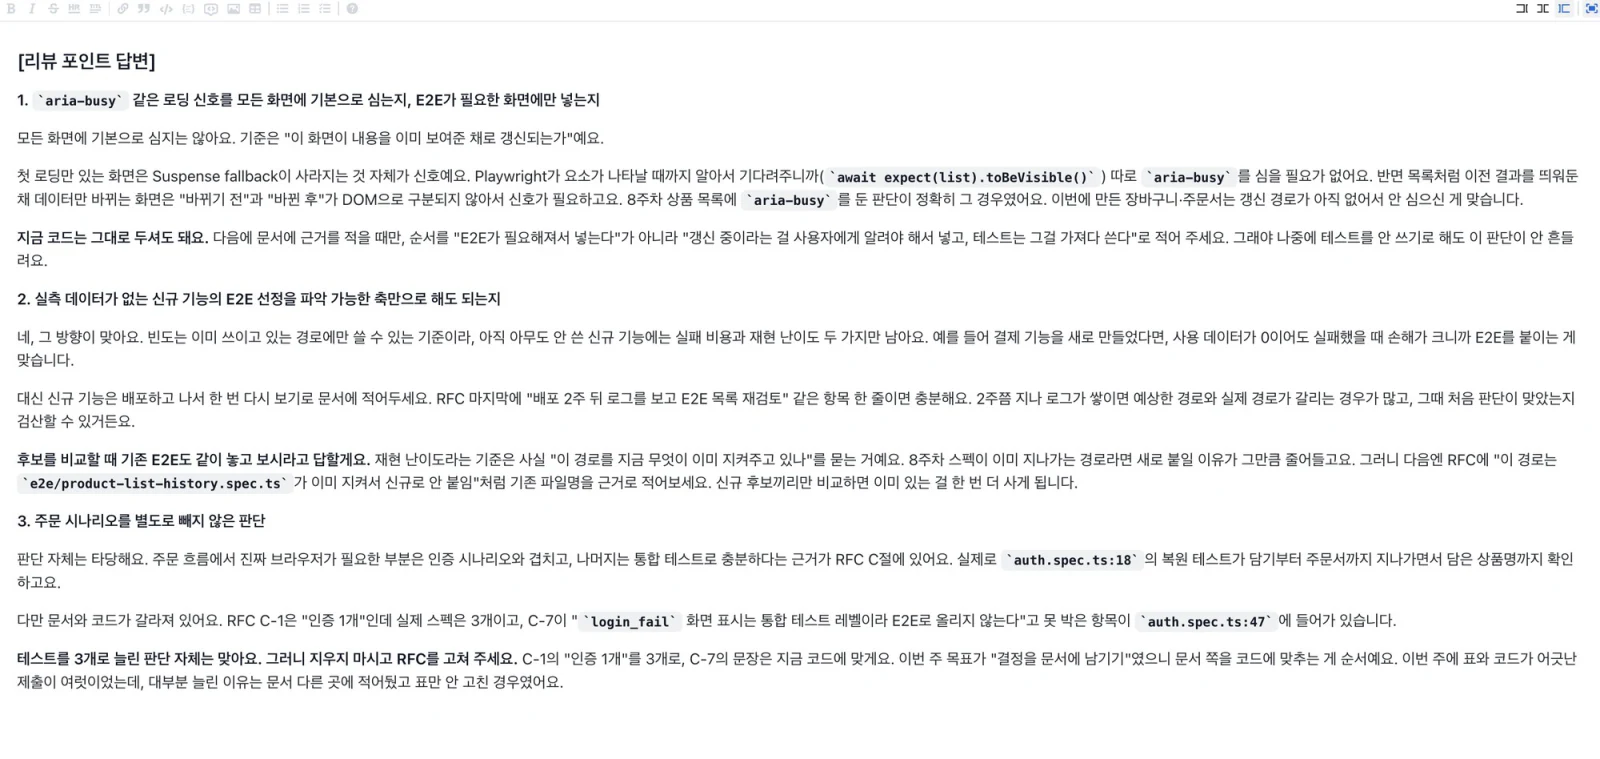
9주차 — 비싼 테스트를 어디에 붙일지 (클릭하면 원본 크기)
8절 — 누구에게 권하나
권하고 싶은 쪽은 이렇습니다.
- AI에 구현을 맡기는데, 그걸 받아들일 검토 기준이 없는 사람. 10주 전의 저입니다
- 실무 경력은 있는데 성능·테스트·배포가 남의 일인 사람
- 혼자서는 근거를 끝까지 밀고 가기 어려운 사람. 지적해 줄 사람과 마감이 있어야 그 순서를 끝까지 밟게 되는 유형
- 사내 서비스에 손대고 싶은 지점이 있는데, 근거를 만드는 방법을 모르는 사람
반대로 안 맞는 경우도 분명합니다.
주당 시간을 못 내는 분에게는 권하지 않습니다. 이 과정은 코드를 빨리 내는 훈련이 아니라 결정과 고민을 요구하는 훈련이라, 시간을 줄이면 줄인 만큼이 아니라 그 이상이 사라집니다. 측정을 5회가 아니라 1회만 하면 시간은 5분의 1이 되지만 얻는 건 0에 가깝습니다. 재보나 마나인 숫자가 되니까요. 6절에 적은 20~30시간이 나올 수 없는 상황이라면 다음 기수를 기다리는 편이 낫다고 생각합니다.
10주 동안 배운 건 React의 어떤 기능이 아니었습니다. 무엇을 근거로 정했는지 말할 수 있는 상태와, 그냥 그렇게 한 상태의 차이였습니다.
문제를 해결할 때 과정에서 익힌 판단 기준들과 그 의미를 생각하면서, 스스로와 다른 사람에게 설명 가능한 최선의 선택을 해보려고 합니다.
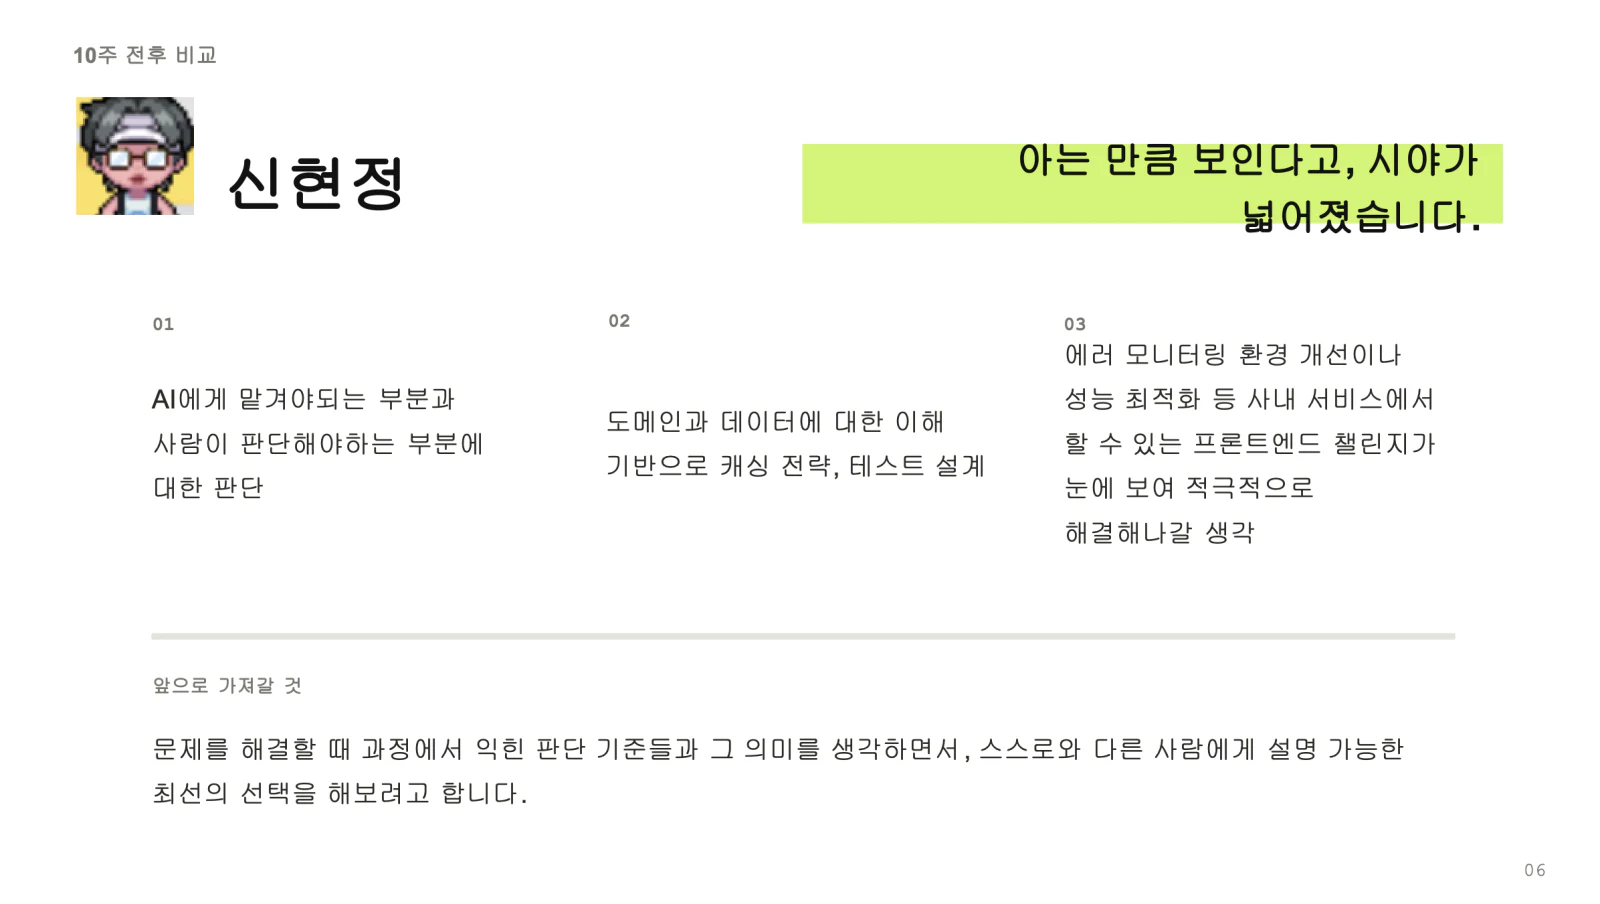
마지막 발표에서 정리한 10주 전후 비교
#루퍼스부트캠프 #루퍼스 #루프팩 #프론트엔드 #LOOPPAK #루프팩프론트엔드1기